Skip to content

5.9.6 基于知识的模糊系统 ​

在技术和非技术领域中, 单位区间上的多值模糊逻辑有多种应用的可能性. 一般性概念包括: 量和特征数的模糊化, 通过适当的知识基础和运算将它们聚合, 以及如有必要还包括将可能的模糊结果集合逆模糊化.

5.9.6.1 Mamdani 方法 ​

下列步骤用于模糊控制过程:

(1)法则基础 设,例如,对于第 i 个法则

Ri : 如果 e 是 Ei 并且 e˙ 是 ΔEi ,那么 u 是 Ui .(5.389)

其中 e 刻画误差, e˙ 刻画误差的变化, u 刻画 (非模糊值的) 输出值的变化. 每个量在其区域 E,ΔE 和 U 中定义. 令整个区域是 E×ΔE×U . 误差和误差的变化将在这个区域中模糊化, 即它们由模糊集表示, 这里使用了语言描述.

(2) 模糊化算法一般地,误差 e 及其变化 e˙ 不是模糊值,所以它们必须通过有效的描述模糊化. 模糊值将与法则基础中 IF THEN 法则的前提加以比较. 由此推出, 哪些法则是起作用的, 以及它们的权有多大.

(3) 聚合模 具有各自不同权的起作用的法则将与一个代数运算相结合并应用于逆模糊化.

(4)决策模 在逆模糊化过程中将对控制量给出清晰值. 应用逆模糊化运算, 非模糊值的量是从可能值即清晰量的集合中确定的. 这个量表示应该怎样确定系统的控制参数以保持偏差极小.

模糊控制意味着步骤 (1)---(4) 是重复的, 直到达到取得最小的偏差及其变化的目的.

5.9.6.2 菅野方法 ​

菅野 (Sugeno) 方法也用来设计模糊控制程序. 它与 Mamdani 概念的差别在于法则基础和逆模糊化方法. 它有下列步骤:

(1)法则基础 法则基础由下列形式的法则组成:

Ri : 如果 x1 是 A1i ,并且 ⋯ ,并且 xk 是 Aki ,

(5.390)那么ui=p0i+p1ix1+p2ix2+⋯+pkixk.

其中各个记号的意义是:

Aj : 由隶属函数确定的模糊集;

xj : 清晰输入值,如误差 e 和误差的变化 e˙ ,它们有时告诉我们关于系统动力学的一些信息;

pji:xj(j=1,2,⋯,k) 的权;

ui : 属于第 i(i=1,2,⋯,n) 个法则的输出值.

(2) 模糊算法 对于每个法则 Ri 算出 μi∈[0,1] .

(3) 决策模 非模糊值的量是从 ui 的加权平均计算出来的,其中权是模糊化

(5.391)u=∑i=1n⁡μiui(∑i=1n⁡μi)−1

中的 μi .

在此不进行 Mamdani 方法的逆模糊化. 问题是要得到有效的权参数 pji . 这些参数可以用机器学习方法, 例如人工神经网络 (ANN) 确定.

5.9.6.3 认知系统 ​

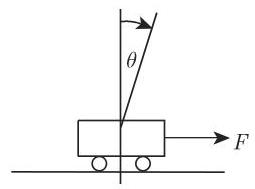
为了清楚地了解方法, 我们应用 Mamdani 方法研究下面著名的例子: 摆的校准 (使它垂直于它的活动底座)(图 5.78). 控制过程的目的是保持摆的平衡使得摆杆是垂直的, 即对于垂直方向的角位移及角速度为零. 这必须通过一个作用于摆的下端的力 F 才能做到. 这个力是控制量. 其模型基于人类 “控制专家” 的能动性 (认知问题). 专家用语言法则表述它的知识. 一般地, 语言法则由前提即测量值的说明, 以及给出适当的控制值的结论组成.
019363af-d8ae-7006-ac42-15a9aafbc2ce_215_695_1235_255_189_0.jpg

对于每个被测量的值 X1,X2,⋯,Xn 的集合以及控制量 Y ,定义适当的语言项: “几乎为零” “小的正数” 等. 这里 “几乎为零” 对于测量值 ξ1 以及测量值 ξ2 可以有不同的意义.

活动底座上的逆摆(图 5.78)

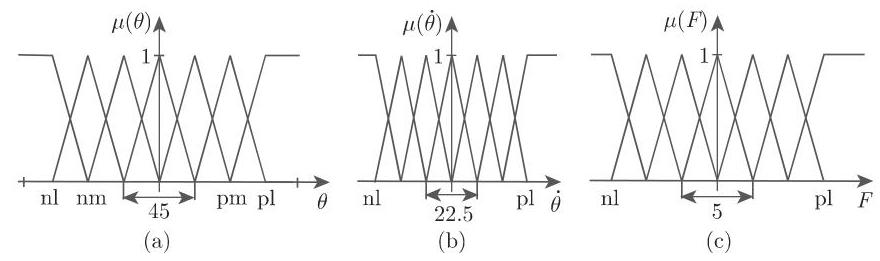
(1) 建模 对于集合 X1 (角的值) 以及类似的对于输入量 X2 (角速度的值),选取 7 个语言项: 负大 (nl), 负中 (nm), 负小 (ns), 零 (z), 正小 (ps), 正中 (pm) 和正大 (pl).

为了数学建模, 如同我们对于模糊推理所指出的 (参见第 572 页 5.9.4), 必须对这些语言项中的每一个设定一个模糊集 (图 5.77).

(2) 选取值的范围

  • 角的值: Θ(−90∘<Θ<90∘):X1:=[−90∘,90∘] .

  • 角速度的值: Θ˙(−45∘s−1≤Θ˙≤45∘s−1):X2:=[−45∘s−1,45∘s−1] .

  • 力的值: F(−10N≤F≤10N):Y:=[−10N,10N] .

输入量 X1 和 X2 以及输出量 Y 的划分的图示见图 5.79. 通常初始值是精确测量值,例如, Θ=36∘,Θ˙=−2.25∘s−1 .

019363af-d8ae-7006-ac42-15a9aafbc2ce_216_380_675_880_261_0.jpg

(3) 法则的选取 考虑下面的表,其中有 49(=7×7) 个可能的法则,但只有 19 个在实际中是重要的,例如我们来讨论下面两个: R1 和 R2 .

表: 含 19 个有实际意义的法则的法则基础

Θ∖Θ˙

nl

nm

ns

Z

ps

pm

pl

nl

ps

pl

nm

pm

ns

nm

ns

ps

Z

nl

nm

ns

Z

ps

pm

pl

ps

ns

ps

pm

pm

nm

pl

nl

ns

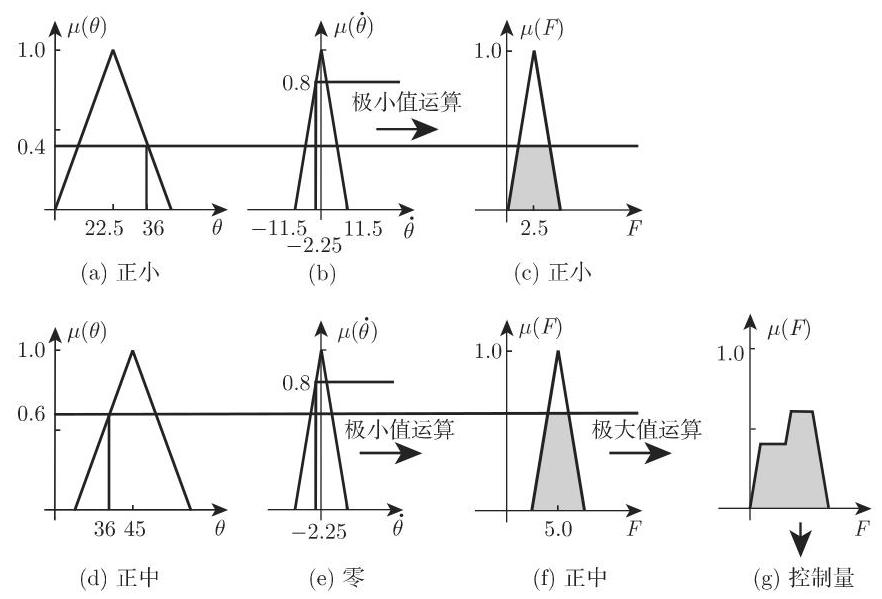
R1 : 如果 Θ 是正小 (ps),并且 Θ˙ 是零 (z),那么 F 是正小 (ps). 对于前提的满足等级 (也称为法则的权),由 α=min{μ(1)(Θ),μ(1)(Θ˙)}=min{0.4,0.8}= 0.4,我们通过 α 切割得到输出集 (5.392),因此输出模糊集在高度 α=0.4 是正小 (ps)(图 5.80(c)) .

(5.392)μ36;−2.25输出 (y)={25y,0≤y<1,0.4,1≤y≤4,2−25y,4<y≤5,0, 其他. 

R2 : 如果 Θ 是正中(pm),并且 Θ˙ 是零(z),那么 F 是正中(pm). 对于前提的满足等级,由 α=min{μ(2)(Θ),μ(2)(Θ˙)}=min{0.6,0.8}=0.6 ,类似于法则 R1

得到输出集 (5.393)(图5.80∘(f)) :

(5.393)μ36;−2.25输出 (y)={25y−1,2.5≤y<4,0.6,4≤y≤6,3−25y,6<y≤7.5,0, 其他. 

019363af-d8ae-7006-ac42-15a9aafbc2ce_217_380_823_882_599_0.jpg

(4) 决策逻辑 法则 R1 应用极小值运算的计算产生图 5.80(a) ∼ (c) 中的模糊集. 对于法则 R2 相应的计算结果见图 5.80(d)∼(f) . 控制量是应用逆模糊化方法由模糊命题集最后算出的图 (5.80(g)) . 应用极大值运算并且考虑模糊集 (图 5.80(c)) 和 (图 5.80(f)) 得到的结果是模糊集 (图 5.80(g)).

a) 这样得到的模糊集的计算要通过算子聚合 (参见第 570 页极大-极小复合 5.9.3.2,1.) . 决策逻辑产生:

μx1,⋯,xn输出 :Y→[0,1];y→maxr∈{1,⋯,k}⁡{min{μil,r(1)(x1),⋯,μil,r(n)(xn),μir(y)}}.

(5.394)

(5.395)μ36;−2.25输出 (y)={25y,0≤y<1,0.4,1≤y<3.5,25y−1,3.5≤y<4,0.6,4≤y<6,3−25y,6≤y≤7.5,0, 其他 

c) 其余 17 个法则得到对于前提的满足等级等于零, 即得到本身是零的模糊集.

(5) 逆模糊化意味着要应用逆模糊化方法确定控制量.

应用重心法和极大值准则法得到控制量的值 F=3.95 或 F=5.0 .

(6) 注记

(1)“基于知识”的路线建立在法则基础之上, 因而最终目的以法则偏差最小为中心.

(2) 应用逆模糊化时迭代过程被引进, 它最终抵达分区空间的中心, 即得到零控制量.

(3) 每个非线性特征域可以通过选择紧域上的适当参数以任意精确度逼近.

5.9.6.4 基于知识的插值系统 ​

1. 插值技巧 ​

可以借助模糊逻辑建立插值技巧. 模糊系统是处理模糊信息的系统. 有可能将它们用于函数逼近或插值. 一个可用来研究这个性质的简单的模糊系统是 Sugeno 控制器. 它有 n 个输出变量 ξ1,⋯,ξn ,并且用形式为

Ri:IF (如果) ξ1 是 A1(i) ,并且 ⋯ ,并且 ξn 是 An(i) ,

(5.396)THEN( 那么 )y=fi(ξ1,⋯,ξn)(i=1,2,⋯,n)

的法则 R1,⋯,Rn 定义输出变量 y 的值. 模糊集 Aj(1),⋯,Aj(k) 总是分割输入集 Xj . 法则的结论 fi(ξ1,⋯,ξn) 是单元素集,它可能与输入变量 ξ1,⋯,ξn 有关.

结论的简单选取能够省去昂贵的逆模糊化,并且输出值 y 将可作为带权的和计算. 为此控制器对每个法则 Ri 用 l 范数从单个输入的隶属等级算出实现等级 αi , 并且确定输出值

(5.397)y=∑i=1N⁡αifi(ξ1,⋯,ξn)∑i=1N⁡αi.

2. 限于 1 维情形 ​

对于仅有一个输入 x=ξ1 的模糊系统,经常应用三角形函数表示的模糊集,它们是在高 0.5 的切割. 这样的模糊集满足下列三个条件:

(1) 对于每个法则 Ri 存在仅满足一个法则的输入 xi . 对于这个输入,输出是用 fi 计算的. 据此,模糊系统的输出在 N 个结点 x1,⋯,xN 上是固定的. 实际上,模糊系统插入了结点 x1,⋯,xN . 在结点 xi 仅有一个法则 Ri 成立的要求对于精确插值是充分的,但不是必要的. 对于我们下面将要考虑的两个法则 R1 和 R2 ,这个要求意味着 α1(x2)=α2(x1)=0 成立. 为了满足第一个条件, α1(x2)=α2(x1)=0 必须成立. 这是结点的精确插值的充分条件.

(2) 至多有两个法则在两个相继的结点间满足. 如果 x1 和 x2 是两个这样的具有法则 R1 和 R2 的结点,那么对于输入 x∈[x1,x2] ,输出 y 是

y=α1(x)f1(x)+α2(x)f2(x)α1(x)+α2(x)=f1(x)+g(x)[f2(x)−f1(x)],(5.398)其中g=:α2(x)α1(x)+α2(x).

x1 与 x2 间插值曲线的确切形状由函数 y 确定. 其形状仅与满足等级 α1 和 α2 有关,这里 α1 和 α2 是隶属函数 μAi(1) 和 μAi(2) 在点 x 的值,即有 α1=μA(1)(x) 及 α2=μA(2)(x) ,或简记为 α1=μ1(x) 及 α2=μ2(x) . 曲线的形状仅与隶属函数的比 μ1/μ2 有关.

(3) 因为隶属函数是正的,所以输出 y 是结论 fi 的凸组合. 对于给定情形和一般情形, (5.399) 和 (5.400) 分别成立:

(5.399)min{f1,f2}≤y≤max{f1,f2}(5.400)mini∈{1,2,⋯,n}⁡fi≤y≤maxi∈{1,2,⋯,n}⁡fi.

对于常数结论,项 f1 和 f2 只引起曲线 g 的形状的平移和伸展. 如果结论与输入变量有关, 那么曲线形状在不同方向有不同的扰动. 因此能够找到另一个输出函数.

对于输入 x 应用线性相关的结论以及和为常数的隶属函数,那么输出是 y= c∑i=1N⁡αi(x)fi(x) ,其中 αi 与 x 有关, c 为常数,于是插值函数是二次多项式. 这些多项式可用于应用二次多项式的插值方法.

一般地,若选取 n 次多项式,那么作为结论可得到 (n+1) 次插值多项式. 在此意义下除用多项式局部插值 (例如用样条) 的约束插值方法外, 模糊系统是基于法则的插值系统的.(朱尧辰 译)

version 1.24.0